Ovo su algoritmi kompresije gdje se ne gubi kvalitet slike. Ove metode osiguravaju istovjetnost dekompresovane i izvorne slike. Navešćemo slijedeće algoritme: Run-length kodovanje, Huffman kodovanje, Entropijsko kodovanje i Kodovanje područja.
|
Run-length kodovanje Run-lenght kodovanje je vrlo jednostavna metoda koja koristi činjenicu da su u mnogim fajlovima česti nizovi istih vrijednosti Ovaj algoritam provjerava fajl, te ubacuje specijalne znakove (engl. ‘token’) svaki put kad naiđe na niz od dva ili više jednakih znakova |
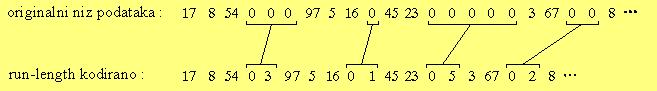
|
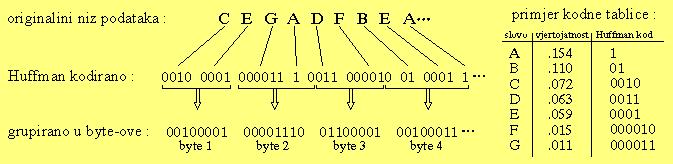
Huffman kodovanje Ovaj algoritam je razvio D.A.Huffman i temelji se na činjenici da se neki znakovi pojavljuju češće nego neki drugi. Na toj osnovi algoritam izgrađuje težinsko binarno stablo (na osnovu frekvencije pojavljivanja pojedinih znakova). Svakom elementu tog stabla pridružuje se nova kodna riječ određena pozicijom znaka u stablu. Najčešće ponavljani znak postaje korjen stabla i njemu se Odnos kompresije iznosi oko 1 : 2 za nekorelirane slike, za tipične slike odnos kompresije iznosi oko 1 : 1.2 do 1 : 2.5. |
|
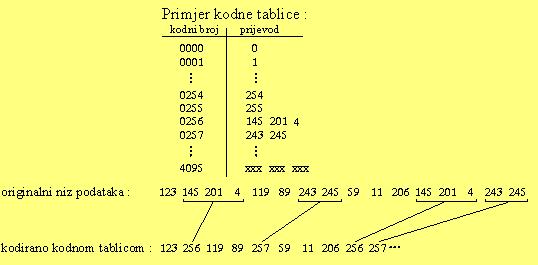
Entropijsko kodovanje Odnos kompresije iznosi do 1 : 8 za prosječne GIF slike. Relativno su problematični za implementaciju budući da sadrže tablice koje rastu s izvođenjem algoritma. |
|
Kodovanje područja To je poboljšana verzija Run-length kodovanja koja iskorištava dvodimenzionalnu karakteristiku slika. Algoritam pokušava pronaći pravougle regije jednakih karakteristika koje se zatim koduju u opisnoj formi kao elementi s dvije tačke i određenom strukturom. Cijela slika treba biti opisana da bi se omogućilo dekodovanje bez gubitaka. Moguće performanse temelje se na vrlo kompleksnom problemu pronalaženja najvećih područja jednakih karakteristika.Vrlo je efikasan način kodovanja, ali zbog svoje nelinearnosti onemogućuje hardware-sku implementaciju, te je relativno spor.
|
 |