Historijski razvoj OCR-a
1929. Gustav Tauschek je patentirao OCR u Njemačkoj, a nakon njega je to isto napravio Handel u SAD-u 1933. 1935. Tauscheku je odobren patent za njegovu metodu i u SAD-u.
Tauschekov uređaj je bio mehanički stroj koji je koristio predloške. Fotodetektor je bio postavljen tako da kad su predložak i znak koji se trebalo prepoznati bili u tačno određenom položaju te ih svjetlost obasjavala ništa svijetla ne bi dolazilo do fotodetektora.
1950. Frank Rowlett, koji je dešifrirao japanski PURPLE diplomatski kod, je zamolio kripto analitičara Davida H. Sheparda (člana Armed Forces Security Agency, SAD) da u suradnji s dr. Louis Tordella da svoje prijedloge za automatiziranu obradu podataka. To je uključivalo i problem pretvorbe isprintanih poruka u strojni jezik za računalnu obradu. Shepard je zaključio da mora biti moguće napraviti takav stroj i uz pomoć prijatelja Harveya Cooka tijekom večeri i vikenda na svom tavanu napravio “Gismo”. To su objavile novine Washington Daily News 27. 4. 1951. i New York Times 26. 12. 1953. nakon što im je odobren patent U.S. Patent Number 2,663,758.
Shepard tada osniva Intelligent Machines Research Corporation (IMR) kompaniju, koja je zaslužna za razvoj prvih nekoliko komercijalnih OCR sustava općenito u svijetu.
Iako su i Gismo i prvi IMR sustavi koristili analizu slike, za razliku od uspoređivanja znakova, te su tolerirali varijaciju fontova, Gismo je bio ograničen na usko vertikalno prepoznavanje, dok su kasniji komercijalni modeli IMR skenera analizirali znakove bilo gdje u skeniranom polju što je zapravo nužnost za stvarne dokumente.
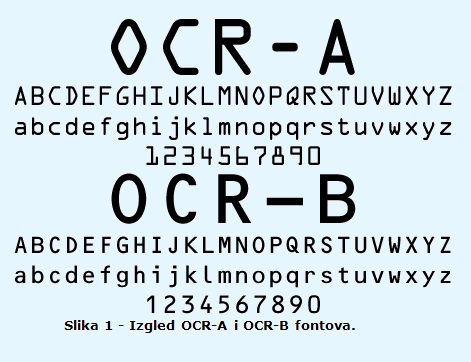
Tokom 1965. Readers Digest i RCA su zajednički proizveli OCR čitač dokumenata koji je čitao serijske brojeve reklamnih kupona. Font koji se koristio na tim dokumentima je bio OCR-A font i printao ga je RCA Drum printer. Čitač je bio izravno spojen na RCA 301 računalo. Specijalizirani čitač dokumenata je zatim postavljen na TWA gdje je obrađivao zrakoplovne karte. Oba ova čitača su mogla obraditi i provjeriti 1500 dokumenata u minuti. U slučaju da neki nisu mogli obraditi, te su izbacili iz daljnje obrade. Ovaj tip čitača je dalje nastavio prodavati RCA u namjeni čitanja raznih računa
Od 1965. poštanska služba SAD-a koristi OCR uređaje temeljene na tehnologiji izumitelja Jacoba Rabinowa za sortiranje pošte. U Europi prvi OCR sustav je koristila Britanska pošta (British General Post Office, GPO), a 1965. se u istoj zemlji počeo koristiti i u bankovnom sustavu. OCR sustavi korišteni u pošti čitaju ime i adresu i zatim isprintaju određeni barkod ovisan o poštanskom kodu na kovertu. Zatim se samo pisma sortiraju prema tom barkodu koji kako bi se izbjegle pogreške se ispisuje tintom koja je vidljiva pod ultraljubičastom svjetlošću.
1974. Ray Kurzweil osniva kompaniju Kurzweil Computer Products, Inc. i vodi razvoj prvog omni-font OCR sustava, tj. računalnog programa sposobnog prepoznati tekst isprintan u bilo kojem normalnom fontu. Namijenio je ovaj uređaj slijepima koji bi im omogućio čitanje dokumenata pomoću računala. Ovo je zahtijevalo izum još dvije tehnologije CCD skenera i text-to-speech (tekst-govor) sintetizatora. 13. 1. 1976. je predstavljen gotov proizvod koji je u potpunosti funkcionirao kako je i zamišljen.
1978. Kurzweil Computer Products su počeli sa prodajom komercijalne verzije OCR računalnog programa. LexisNexis je bio jedan od prvih kupaca koji je tu tehnologiju koristio za prijenos svojih pravnih i ostalih dokumenata u online bazu podataka. Dvije godine kasnije Kurzweil prodaje svoju kompaniju Xerox-u koji je izrazio interes za daljnji razvoj ove tehnologije te je tako Kurzweil Computer Products postao podružnica Xerox-a pod novim imenom Scansoft (danas Nuance).
Trenutno stanje OCR tehnologije
Tačno prepoznavanje isprintane latinice se smatra uglavnom riješenim problemom. Tipičan postotak tačnosti prepoznavanja prekoračuje 99% iako za određene aplikacije koje zahtijevaju još veću tačnost je potrebna ljudska intervencija i pregled grešaka. Ostala područja, poput prepoznavanja rukopisa, kurziva i načina pisanja različitog od latinice (posebno onih sa vrlo velikim brojem znakova) su i dalje predmet aktivnog istraživanja.
Tačnost ili preciznost može biti mjerena na nekoliko načina o kojima jako ovisi krajnji rezultat i postotak tačnosti. Npr., bez korištenja rječnika za ispravljanje pogrešaka pri čitanju 1% pogreška (99% tačnost) se moze pretvoriti u 5% pogrešku (95% tačnost). OCR se ponekad krivo poistovjećuje sa on-line character recognition. OCR je tip off-line prepoznavanja znakova, gdje sustav prepoznaje fiksne i statičke oblike znakova, dok on-line prepoznavanje znakova prepoznaje dinamičke pokrete tokom pisanja rukom. On-line prepoznavanje znakova se ponekad naziva i dinamičko prepoznavanje znakova (dynamic character recognition), prepoznavanje znakova u realnom vremenu (real-time character recognition) i inteligentno prepoznavanje znakova (Intelligent Character Recognition, ICR).